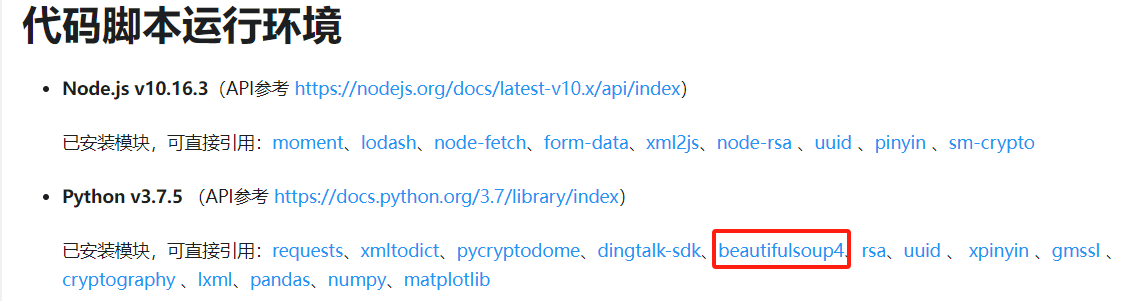
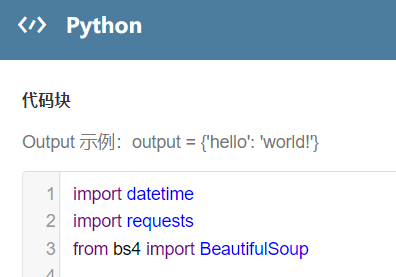
python 模块已安装的beautifulsoup4怎么使用的? MonkeySheepLv.4悟道 发布于 2024-09-27 13:56 最后回复 2024-10-06 14:06:29 问答 pythonbeautifulsoup4 收藏 复制链接 新浪微博 微信扫一扫 分享 4 回复960 浏览 [图片] [图片] [图片] 请问这个 python 中的 beautifulsoup4 是怎么用的? 请问这个 python 中的 beautifulsoup4 是怎么用的?
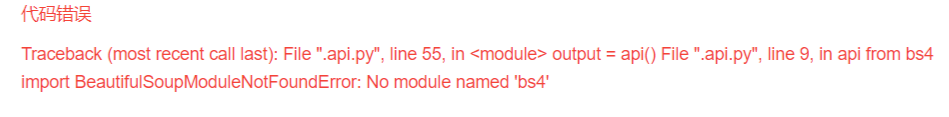
是呀,提示第 9 行出错,你不把第 9 行贴出来,谁能知道
你这个报错是 output 的问题。找 gpt 帮你改代码
进 python 的 docker 里,pip3 list 一下
以下来自 AI:
BeautifulSoup4 是一个用于解析 HTML 和 XML 文档的 Python 库。它创建一个解析树,可以轻松地提取数据。以下是使用 BeautifulSoup4 的基本步骤:
安装 BeautifulSoup4
首先,你需要安装 BeautifulSoup4 和解析器库
lxml或html.parser。可以使用 pip 进行安装:基本用法
以下是一个简单的示例,展示如何使用 BeautifulSoup4 解析 HTML 文档并提取数据:
解析器选择
BeautifulSoup4 支持多种解析器,常用的有:
html.parser:Python 内置的解析器,速度适中,容错能力强。lxml:需要安装lxml库,速度快,容错能力强。html5lib:需要安装html5lib库,完全符合 HTML5 标准,生成浏览器解析的 HTML 文档。选择解析器时,可以根据需求和环境选择合适的解析器。
更多示例和帮助
你可以参考以下资源获取更多示例和帮助:
详情内容请查看文档